Auswahl und Traversierung des DOM-Baums
Im Leitfaden Anatomie des DOM haben wir Eigenschaften vorgestellt, mit denen Sie zwischen Elternknoten, Kindknoten und Geschwisterknoten navigieren können. Den Baum manuell zu durchlaufen, ist jedoch umständlich und fehleranfällig. Das DOM bietet Methoden, mit denen Sie direkt eine Referenz auf ein Element im Baum anhand einer eindeutigen Kennung, eines Klassennamens, eines Tag-Namens, eines CSS-Selektors und weiterer Kriterien erhalten. Außerdem stellt es Hilfsfunktionen bereit, um über die Knoten des Baums zu iterieren.
Baumtraversierung: ein Überblick
Der Leitfaden Anatomie des DOM stellt die Baumstruktur des DOM vor. Der Baum hat eine Wurzel, und jeder Knoten hat eine möglicherweise leere Liste von Kindknoten. Die Dokumentwurzel ist ein Document-Knoten, während Element-Knoten das Grundgerüst dieses Baums bilden.
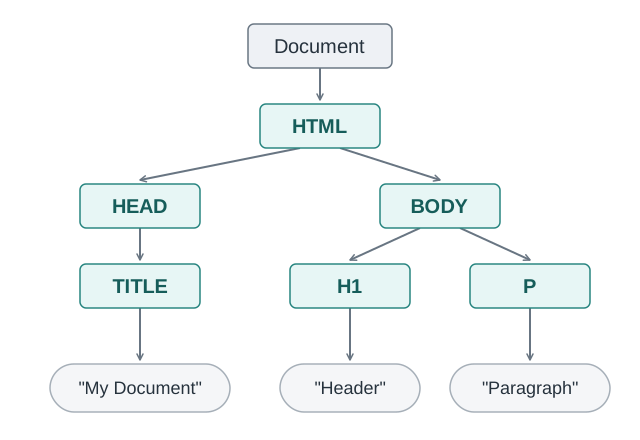
Es gibt viele Möglichkeiten, einen Baum zu durchlaufen, aber das DOM stellt nur eine Reihenfolge bereit: die Tiefensuche mit Besuch des Elternknotens vor seinen Kindknoten (Preorder-DFS). Sie wird als Dokumentreihenfolge oder Baumreihenfolge bezeichnet. Im Pseudocode funktioniert sie so:
function traverseTree(root, visitor) {
  // Visit the root first
  visitor(root);
  for (const child of root.childNodes) {
    // Recursively visit each child in order
    // Each child subtree is completely visited before moving to the next
    traverseTree(child, visitor);
  }
}
Ein Element steht vor seinen Nachkommen; frühere Geschwisterknoten und deren Nachkommen stehen vor späteren Geschwisterknoten. Im obigen Baum stehen die Element-Knoten beispielsweise in dieser Baumreihenfolge: HTML, HEAD, TITLE, BODY, H1, P.
Die Auswahl ist lediglich eine Form der Traversierung, bei der visitor eine boolesche Funktion ist, die angibt, ob uns ein Element interessiert.
function selectTree(root, visitor) {
  // visitor successfully matches the root node; return without going further
  if (visitor(root)) return root;
  for (const child of root.childNodes) {
    const result = selectTree(child, visitor);
    // A result is successfully found within the subtree at child
    if (result !== null) return result;
  }
  // No match found anywhere in the subtree at root
  return null;
}

function selectTreeMulti(root, visitor, collection) {
  if (visitor(root)) collection.push(root);
  for (const child of root.childNodes) {
    selectTreeMulti(child, visitor, collection);
  }
  return collection;
}
Wenn Sie diese Konzepte verstehen, verstehen Sie bereits einen großen Teil der Auswahl und Traversierung im DOM. Es bleibt nur noch zu klären, wie die einzelnen spezialisierten DOM-Methoden ihre visitor-Funktion und ihr collection-Objekt für Sie definieren.
Elemente anhand von ID, Klasse oder Tag-Namen auswählen
Es gibt drei wichtige Möglichkeiten, ein Element zu identifizieren: seine id, seinen className und seinen tagName. Die Schnittstelle Document stellt drei Methoden bereit, um anhand dieser Kennungen auszuwählen:
Wie die Namen nahelegen, gibt getElementById() die Referenz auf ein einzelnes Element zurück (oder null, wenn kein Element gefunden wird), während getElementsByClassName() und getElementsByTagName() Sammlungen von Elementen zurückgeben. Bei der Sammlung handelt es sich um eine dynamische HTMLCollection. Darauf gehen wir unter Arbeiten mit Sammlungen näher ein.
Die id jedes Elements sollte innerhalb des Dokuments eindeutig sein (Shadow DOM verfügt jedoch über eigene Geltungsbereiche). Solange Sie diese Anforderung in Ihrem Code einhalten, erhalten Sie mit getElementById() stets das gewünschte Element. id-Attribute werden allerdings sparsam eingesetzt, da es schwierig ist, ihre globale Eindeutigkeit sicherzustellen. Daher sind in realen Anwendungen getElementsByClassName() und getElementsByTagName() (oder die Abfragemethoden, die wir gleich vorstellen) oft praktischer.
<div id="container"></div>
<div class="profile big"></div>
const containerDiv = document.getElementById("container");
// containerDiv is an HTMLDivElement

const profileDivs = document.getElementsByClassName("profile");
// profileDivs is an HTMLCollection containing an HTMLDivElement

const profileDivs2 = document.getElementsByTagName("div");
// profileDivs2 is an HTMLCollection containing both HTMLDivElements
Einige wichtige Hinweise:
- Die Methode
getElementById()vergleicht IDs unter Berücksichtigung der Groß- und Kleinschreibung. AuchgetElementsByClassName()berücksichtigt die Groß- und Kleinschreibung, außer im Quirks-Modus, in dem der Vergleich ohne Berücksichtigung der ASCII-Groß- und Kleinschreibung erfolgt. - In HTML-Dokumenten wandelt
getElementsByTagName()das Argument beim Abgleich mit HTML-Elementen in Kleinbuchstaben um. Nicht-HTML-Elemente (z. B. SVG) werden weiterhin unter Berücksichtigung der Groß- und Kleinschreibung abgeglichen. In XML-Dokumenten wird bei allen Tag-Namen die Groß- und Kleinschreibung berücksichtigt. Beachten Sie, dasstagNamefür ein HTML-Element in einem HTML-Dokument in Großbuchstaben zurückgegeben wird, intern aber weiterhin in Kleinbuchstaben gespeichert ist. - Der Wert des Attributs
classist eine durch Leerzeichen getrennte Liste aus einem oder mehreren Klassennamen. Auch fürgetElementsByClassName()können Sie eine solche Liste angeben.visitorprüft dann, ob diese Liste eine Teilmenge der Klassennamen des Elements ist. Ein Element stimmt also überein, wenn alle angegebenen Klassennamen bei ihm vorhanden sind; zusätzliche Klassennamen sind zulässig. - Die Methode
getElementsByTagName()akzeptiert den besonderen Wert"*", um alle Elemente abzurufen (also keine Filterung vorzunehmen).
Falls Sie mit CSS-Selektoren vertraut sind: Diese Methoden sind die DOM-Entsprechungen der ID-, Klassen-, Typ- und Universalselektoren:
/* document.getElementById("container") */
#container {
}

/* document.getElementsByClassName("profile") */
.profile {
}

/* document.getElementsByClassName("profile big") */
.profile.big {
}

/* document.getElementsByTagName("div") */
div {
}

/* document.getElementsByTagName("*") */
* {
}
Die Methode getElementById() ist auch für DocumentFragment verfügbar; getElementsByClassName() und getElementsByTagName() sind auch für Element verfügbar. Wenn Sie eine Methode auf einem Knoten aufrufen, wird dieser Knoten zur Wurzel der Suche. Die aufrufende Wurzel selbst wird nie als Treffer berücksichtigt.
Elemente mit CSS-Selektoren auswählen
Sie können Elemente auch direkt mit CSS-Selektoren auswählen. Auf Document stehen dafür zwei Methoden zur Verfügung:
Beide Methoden durchsuchen die Nachkommen, nicht aber den Knoten, auf dem sie aufgerufen werden. querySelector() gibt das erste passende Element zurück; querySelectorAll() gibt alle passenden Elemente in einer statischen NodeList zurück. Diese Sammlung stellen wir unter Arbeiten mit Sammlungen genauer vor.
Die Methoden akzeptieren Selektoren, anhand derer bestimmt wird, welches Element oder welche Elemente zurückgegeben werden. Dazu gehören auch Selektorlisten, mit denen Sie mehrere Selektoren in einer einzigen Abfrage zusammenfassen können.
Um alle Absatz-Elemente (p) in einem Dokument auszuwählen, deren Klassen warning oder note enthalten, können Sie Folgendes tun:
const special = document.querySelectorAll("p.warning, p.note");
Sie können auch anhand einer ID suchen. Zum Beispiel:
const el = document.querySelector("#main, #basic, #exclamation");
Nach Ausführung des obigen Codes enthält el das erste Element im Dokument, dessen ID main, basic oder exclamation ist. Die Reihenfolge der Selektoren in der Liste gibt keiner ID Vorrang vor einer anderen. Ein Element, auf das mehrere Selektoren zutreffen, erscheint im Ergebnis von querySelectorAll() nur einmal.
Pseudoklassen wie :checked und :first-child können in Abfragen verwendet werden. Zum Schutz der Privatsphäre der Benutzer werden einige Pseudoklassen nicht unterstützt oder verhalten sich anders. Beispielsweise liefert :visited keine Treffer, und :link wird wie :any-link behandelt. Es können nur Elemente ausgewählt werden. Pseudoelemente wie ::before liefern daher keine passenden DOM-Elemente.
Die querySelector-Methoden decken im Wesentlichen alle Möglichkeiten der zuvor vorgestellten getElementBy-Methoden und darüber hinaus ab. Alles, was Sie mit Letzteren umsetzen können, lässt sich mit Ersteren auf ähnliche Weise erreichen:
document.getElementById("container");
// Is equivalent to:
document.querySelector("#container");

document.getElementsByClassName("profile big");
// Is equivalent to:
document.querySelectorAll(".profile.big");

document.getElementsByTagName("div");
// Is equivalent to:
document.querySelectorAll("div");
Sie müssen lediglich zwei Dinge beachten:
-
getElementsByClassName()undgetElementsByTagName()geben dynamische Sammlungen zurück, währendquerySelectorAll()eine statische Sammlung zurückgibt (siehe Dynamische und statische Sammlungen). Meist ist das Verhalten der statischen Sammlung erwünscht. -
Die Selektorzeichenfolge muss eine gültige CSS-Selektorsyntax aufweisen. Andernfalls löst die Methode eine
DOMExceptionvom TypSyntaxErroraus. Eine HTML-ID oder ein Klassenname ist nicht unbedingt ein gültiger CSS-Bezeichner. Verwenden SieCSS.escape(), wenn Sie einen solchen Wert in einen ID- oder Klassenselektor einfügen:jsconst id = "item:42"; const item = document.querySelector(`#${CSS.escape(id)}`); // document.getElementById(id) needs no escaping.
Beide Abfragemethoden sind auch für DocumentFragment und Element verfügbar. Wenn Sie querySelector() oder querySelectorAll() auf einem Element aufrufen, werden nur dessen Nachkommen zurückgegeben; der Selektor wird jedoch im Kontext des gesamten Dokuments angewendet. Betrachten Sie beispielsweise dieses HTML:
<div>
  <section id="main">
    <p class="note">A direct child.</p>
    <div>
      <p class="note">A nested paragraph.</p>
    </div>
  </section>
</div>
Ein Selektor wie div p stimmt weiterhin mit der ersten Notiz überein, da dieses p tatsächlich in einem div verschachtelt ist, obwohl sich dieses div außerhalb der Suchwurzel befindet. Verwenden Sie :scope, um den Selektor nur innerhalb der Suchwurzel anzuwenden:
const main = document.getElementById("main");
const allNotes = main.querySelectorAll("div p"); // Both paragraphs
const childNote = main.querySelectorAll(":scope div p"); // Only the second
const childNote2 = main.querySelectorAll(":scope > p"); // Only the first
Die Methode Element.matches() prüft, ob ein Element mit der Selektorzeichenfolge übereinstimmt. querySelector() funktioniert daher ähnlich wie die Funktion selectTree, wenn element.matches als visitor-Funktion übergeben wird (trotz zahlreicher technischer Unterschiede).
Mit der Methode Element.closest() können Sie auch nach oben suchen. Sie prüft zunächst das Element selbst, dann sein Elternelement und so weiter in Richtung der Wurzel, bis sie ein Vorfahrenelement findet, das mit dem angegebenen Selektor übereinstimmt.
Mit demselben HTML:
const innerNote = document.querySelector("#main div p.note");
console.log(innerNote.closest("section").id); // "main"
Arbeiten mit Sammlungen
Wir haben bereits zwei Arten von Sammlungen vorgestellt:
- eine dynamische
HTMLCollection, wie sie vongetElementsByClassName()undgetElementsByTagName()zurückgegeben wird - eine statische
NodeList, wie sie vonquerySelectorAll()zurückgegeben wird
Eine NodeList kann Knoten beliebiger Typen enthalten, während eine HTMLCollection nur Elemente enthält (die allerdings keine HTML-Elemente sein müssen). Möglicherweise kennen Sie bereits die Eigenschaft Node.childNodes, die ebenfalls eine NodeList ist. Die von querySelectorAll() zurückgegebene NodeList enthält nur Elemente, weil diese Methode Elemente auswählt.
Beide Schnittstellen sind Array-ähnlich. Das bedeutet, dass sie eine length-Eigenschaft haben und den Zugriff über Indizes unterstützen. Außerdem unterstützen sie die Iteration.
const paragraphs = document.querySelectorAll("p");
console.log(paragraphs.length);
console.log(paragraphs[0]);

for (const para of paragraphs) {
  // ...
}
Sie sind jedoch keine echten Array-Objekte und verfügen daher nicht über Methoden wie Array.prototype.map(). Wenn Sie solche Methoden benötigen, können Sie die Sammlungen mit der Spread-Syntax oder Array.from() in Arrays umwandeln:
const paragraphs = [...document.querySelectorAll("p")];
const paragraphs2 = Array.from(document.querySelectorAll("p"));

const texts = paragraphs.map((p) => p.textContent);
Die Schnittstellen NodeList und HTMLCollection waren – zusammen mit vielen anderen Array-ähnlichen Schnittstellen im Web – ein Versuch, eine nicht veränderbare Liste zu schaffen. Sie bieten keine Möglichkeit, sie direkt zu verändern, und Änderungen an den daraus erzeugten Arrays wirken sich nicht auf die ursprüngliche Liste aus.
Eine HTMLCollection ist nicht nur eine Liste, sondern auch eine Schlüssel-Wert-Zuordnung, die das Nachschlagen anhand der ID eines Elements oder des name eines HTML-Elements ermöglicht. Sie können dafür entweder namedItem() verwenden oder direkt über Eigenschaften auf die Elemente zugreifen (solange deren Namen nicht mit vorhandenen Eigenschaftsnamen der HTMLCollection kollidieren).
const sections = document.getElementsByTagName("section");
const main = sections.namedItem("main");
const main2 = sections["main"];
Die Schnittstellen bieten einige zusätzliche praktische Methoden:
- Beide Schnittstellen bieten eine Methode
item(), die ähnlich wie der Zugriff über einen Index funktioniert. Der Hauptunterschied besteht darin, dass sienullzurückgibt, wenn der Index außerhalb des gültigen Bereichs liegt, während der Zugriff über einen Indexundefinedzurückgibt. Außerdem gelten unterschiedliche Regeln für die Umwandlung der Eingabe. NodeListbietetforEach(),entries(),keys()undvalues(). Sie funktionieren genauso wie die entsprechenden Methoden vonArray. Wenn Sie nur diese Methoden benötigen, müssen Sie dieNodeListnicht in einArrayumwandeln.
Dynamische und statische Sammlungen
Die von getElementsByTagName() und getElementsByClassName() zurückgegebenen HTMLCollection-Objekte sind dynamisch. Im Wesentlichen speichert die Sammlung zunächst keine Ergebnisse, sondern merkt sich nur das Wurzelelement und die Abfrage. Erst wenn Sie ihre Länge oder ein enthaltenes Element abrufen, führt sie die eigentliche Traversierung des aktuellen DOM-Baums durch. (In einem realen Browser kann dies aufgrund von Optimierungen anders umgesetzt sein.) Wenn Sie die Sammlung speichern und anschließend den DOM-Baum ändern, spiegelt die Sammlung den aktualisierten DOM-Baum wider.
const container = document.createElement("div");
const paragraph = document.createElement("p");
paragraph.className = "note";
container.append(paragraph);

const liveList = container.getElementsByClassName("note");
console.log(liveList.length); // 1

paragraph.classList.remove("note");
console.log(liveList.length); // 0
Das von querySelectorAll() zurückgegebene NodeList-Objekt ist dagegen statisch: Es ist eine Momentaufnahme des Baumzustands zum Zeitpunkt des Methodenaufrufs. Eine statische Liste behält bei, welche Knoten sie enthält, nicht aber deren Zustand: Sie verweist weiterhin auf die ursprünglichen Knotenobjekte.
const container = document.createElement("div");
const paragraph = document.createElement("p");
paragraph.className = "note";
container.append(paragraph);

const staticList = container.querySelectorAll(".note");
console.log(staticList.length); // 1

paragraph.classList.remove("note");
console.log(staticList.length); // 1
console.log(staticList[0].className); // ""
Meist ist eine statische Liste das, was Sie benötigen. Um Array-Methoden zu verwenden, müssen Sie die Sammlungen ohnehin fast immer in Arrays umwandeln; danach ist die Sammlung nicht mehr dynamisch. Wenn Sie außerdem eine dynamische Sammlung während der Iteration verändern, können sich ihre Indizes und ihre Länge ändern. Das kann zu unbeabsichtigten gleichzeitigen Änderungen führen:
const notes = document.getElementsByClassName("note");
for (const note of notes) {
  // This simultaneously removes this element from the collection, shifting
  // all later elements, so the next iteration doesn't visit the next element
  note.classList.remove("note");
}
Um dies zu vermeiden, iterieren Sie über eine Momentaufnahme, etwa ein mit Array.from(notes) erstelltes Array oder eine mit querySelectorAll(".note") erhaltene statische Liste. Alternativ können Sie Änderungen, die die enthaltenen Elemente oder deren Reihenfolge beeinflussen, bis nach der Iteration aufschieben. Eine Referenz auf die dynamische Sammlung können Sie dennoch behalten, um spätere Aktualisierungen zu beobachten.
Knoten durchlaufen
Selektormethoden können verwendet werden, um über Elemente zu iterieren, zum Beispiel so:
for (const descendant of element.querySelectorAll("*")) {
  // Visit every single descendant element in this subtree
}
Das ist jedoch recht eingeschränkt: Sie können weder Nicht-Elemente wie Textknoten oder Kommentare besuchen noch einen bestimmten Teilbaum auslassen, ohne komplizierte Selektoren zu schreiben. Das DOM stellt zwei Schnittstellen für die allgemeine Traversierung bereit: NodeIterator und TreeWalker. Das folgende Beispiel durchläuft etwa alle Knoten, einschließlich Textknoten und Kommentare:
const nodeIterator = document.createNodeIterator(document);
let node = nodeIterator.nextNode();
while (node) {
  console.log(node.nodeName);
  node = nodeIterator.nextNode();
}
Um einen NodeIterator oder TreeWalker zu erstellen, rufen Sie document.createNodeIterator() beziehungsweise document.createTreeWalker() auf. Beide Methoden nehmen dieselben drei Argumente entgegen:
root: Der Knoten, an dem die Traversierung beginnt.whatToShowOptional: Gibt an, welche Knotentypen besucht werden sollen. Ein nicht besuchter Knoten kann dennoch Nachkommen haben, die besucht werden. Der Standardwert istNodeFilter.SHOW_ALL.filterOptional: Eine Funktion oder ein Objekt mit einer MethodeacceptNode(node), die beziehungsweise das die besuchten Knoten weiter einschränkt. Die Funktion kann entscheiden, ob ein Knoten übersprungen werden soll und, falls ja, ob auch seine Nachkommen übersprungen werden sollen (Letzteres nur beiTreeWalker). Der Standardwert istnull, was bedeutet, dass keine zusätzliche Filterung erfolgt.
Beide Objekte stellen diese Einstellungen über ihre schreibgeschützten Eigenschaften root, whatToShow und filter bereit.
Die Schnittstelle NodeFilter stellt Konstanten für whatToShow bereit.
| Konstante | Angezeigte Knoten |
|---|---|
NodeFilter.SHOW_ALL |
Alle |
NodeFilter.SHOW_ATTRIBUTE |
Attr |
NodeFilter.SHOW_CDATA_SECTION |
CDATASection |
NodeFilter.SHOW_COMMENT |
Comment |
NodeFilter.SHOW_DOCUMENT |
Document |
NodeFilter.SHOW_DOCUMENT_FRAGMENT |
DocumentFragment |
NodeFilter.SHOW_DOCUMENT_TYPE |
DocumentType |
NodeFilter.SHOW_ELEMENT |
Element |
NodeFilter.SHOW_PROCESSING_INSTRUCTION |
ProcessingInstruction |
NodeFilter.SHOW_TEXT |
Text |
Hinweis:
Die Konstante NodeFilter.SHOW_ATTRIBUTE ist nur wirksam, wenn die Wurzel ein Attributknoten ist. Da der Elternknoten jedes Attr-Knotens immer null ist, geben TreeWalker.nextNode() und TreeWalker.previousNode() niemals einen Attr-Knoten zurück. Um Attr-Knoten zu durchlaufen, verwenden Sie stattdessen Element.attributes.
Alle diese Konstanten sind Bitmasken. Sie können daher mit dem bitweisen ODER-Operator (|) mehrere Konstanten kombinieren, um mehrere Knotentypen einzubeziehen. Mit NodeFilter.SHOW_ELEMENT | NodeFilter.SHOW_TEXT beziehen Sie beispielsweise sowohl Element- als auch Textknoten ein.
Ein Knoten, der whatToShow nicht erfüllt, wird niemals an die Funktion filter übergeben. Er kann jedoch trotzdem Nachkommen haben, die besucht werden.
Die Funktion filter (oder ihre Methode acceptNode()) wird aufgerufen, wenn bei der Traversierung ein möglicher Knoten geprüft wird, dessen Typ mit whatToShow übereinstimmt. Nachkommen eines von TreeWalker verworfenen Teilbaums erreichen den Filter möglicherweise nie. Der Filter muss eine dieser Konstanten zurückgeben:
NodeFilter.FILTER_ACCEPT: Der Knoten wird zurückgegeben.NodeFilter.FILTER_SKIP: Der Knoten wird übersprungen, seine Nachkommen werden aber weiterhin berücksichtigt.NodeFilter.FILTER_REJECT: BeiTreeWalkerwerden der Knoten und alle seine Nachkommen übersprungen; beiNodeIteratorverhält sich die Konstante wieFILTER_SKIP.
Das folgende Beispiel iteriert über alle Textknoten, die nicht nur aus Leerraum bestehen:
const iterator = document.createNodeIterator(
  document.body,
  NodeFilter.SHOW_TEXT,
  (node) =>
    node.data.trim() ? NodeFilter.FILTER_ACCEPT : NodeFilter.FILTER_SKIP,
);
Mit NodeIterator in Baumreihenfolge iterieren
Ein NodeIterator besucht Knoten mit nextNode() in Baumreihenfolge und mit previousNode() in umgekehrter Baumreihenfolge. Jeder Aufruf gibt einen vom Filter akzeptierten Knoten zurück oder null, wenn in der jeweiligen Richtung kein solcher Knoten vorhanden ist.
Wenn Sie das vorherige Beispiel fortsetzen, können Sie sich fortlaufend in Baumreihenfolge vorwärtsbewegen und jeden Textknoten protokollieren:
let node;
while ((node = iterator.nextNode())) {
  console.log(node.data);
}
Abstrakt betrachtet funktioniert NodeIterator so, als würde er eine Liste der Knoten verwalten, die den Filter passiert haben, sortiert in Baumreihenfolge (tatsächlich speichert er diese Liste nicht). Der Iterator verfolgt eine Position unmittelbar zwischen zwei Knoten dieser Liste, die durch referenceNode und pointerBeforeReferenceNode dargestellt wird. nextNode() gibt den Knoten unmittelbar rechts von dieser Position zurück, während previousNode() den Knoten unmittelbar links davon zurückgibt. Anfangs ist referenceNode die Wurzel und pointerBeforeReferenceNode ist true. Deshalb gibt der erste Aufruf von nextNode() die Wurzel zurück, sofern sie die Filter passiert. Der erste Aufruf von previousNode() gibt dagegen null zurück, weil links davon nichts liegt. Nach einem erfolgreichen Aufruf von nextNode() ist referenceNode der zurückgegebene Knoten und pointerBeforeReferenceNode ist false; bei previousNode() verhält es sich umgekehrt. Wenn Sie anschließend die Richtung wechseln, wird derselbe Knoten erneut zurückgegeben, sofern er weiterhin die Filter passiert.
Mit TreeWalker im gefilterten Baum navigieren
NodeIterator stellt die gefilterten Knoten als lineare Sammlung dar. Das ist für die Iteration praktisch, erhält aber die Baumstruktur nicht. Mit einem TreeWalker können Sie innerhalb einer gefilterten Ansicht des Baums zwischen den Knotenbeziehungen navigieren.
Abstrakt betrachtet funktioniert TreeWalker so, als würde er einen Baum aus Knoten verwalten, die den Filter passiert haben. Für jeden Knoten in der gefilterten Ansicht sind seine direkten Kindknoten diejenigen seiner Nachkommen im ursprünglichen Baum, zwischen denen kein weiterer Knoten liegt, der ebenfalls den Filter passiert. Denken Sie daran: NodeFilter.FILTER_SKIP überspringt einen Knoten, lässt seine Nachkommen aber zu; NodeFilter.FILTER_REJECT überspringt einen Knoten und alle seine Nachkommen.

Die Eigenschaft currentNode beginnt bei der Wurzel, selbst wenn diese die Filter nicht passiert. Anders als bei einem NodeIterator beginnt ein Aufruf von nextNode() die Suche nach diesem aktuellen Knoten. Die Wurzel selbst wird beim ersten Aufruf daher nie zurückgegeben.
Die folgenden Methoden bewegen currentNode durch die gefilterte Ansicht. Wenn kein entsprechender Knoten gefunden wird, geben sie null zurück und lassen currentNode unverändert: parentNode(), firstChild(), lastChild(), previousSibling(), nextSibling().
Beachten Sie, dass die gefilterte Ansicht möglicherweise kein einzelner Baum ist, wenn die Wurzel den Filter nicht passiert. Verwenden Sie previousNode() und nextNode(), um den vorherigen beziehungsweise nächsten passenden Knoten in Baumreihenfolge zu finden. Dieser kann zu einem anderen gefilterten Baum gehören. Auch diese Methoden geben null zurück und lassen currentNode unverändert, wenn kein solcher Knoten gefunden wird.
Anders als referenceNode eines Iterators ist currentNode beschreibbar. Sie können den Wert speichern und später wieder zuweisen oder den Walker mit walker.currentNode = walker.root auf seine Wurzel zurücksetzen. Bei einer Zuweisung werden die Filter nicht angewendet, und es wird nicht geprüft, ob sich der Knoten innerhalb des Teilbaums der Wurzel befindet. Halten Sie ihn daher innerhalb dieses Teilbaums, wenn die Traversierung dort bleiben soll.
Betrachten Sie beispielsweise dieses HTML:
<article id="article">
  <p>Read <strong>this</strong> paragraph.</p>
  <aside data-skip><p>Ignore this note.</p></aside>
  <p>Read this paragraph too.</p>
</article>
Dieser Walker sammelt Textknoten, die nicht nur aus Leerraum bestehen, und schließt dabei Teilbäume aus, die mit data-skip markiert sind:
const article = document.getElementById("article");
const walker = document.createTreeWalker(
  article,
  NodeFilter.SHOW_ELEMENT | NodeFilter.SHOW_TEXT,
  (node) => {
    if (node.nodeType === Node.ELEMENT_NODE) {
      return node.hasAttribute("data-skip")
        ? NodeFilter.FILTER_REJECT
        : NodeFilter.FILTER_SKIP;
    }
    return node.data.trim() ? NodeFilter.FILTER_ACCEPT : NodeFilter.FILTER_SKIP;
  },
);

const parts = [];
let node;
while ((node = walker.nextNode())) {
  parts.push(node.data);
}
console.log(parts.join(""));
// "Read this paragraph.Read this paragraph too."
SHOW_ELEMENT ist erforderlich, obwohl wir nur Text sammeln: So kann der Filter Elemente mit data-skip prüfen und verwerfen. Bei ausschließlich SHOW_TEXT würden diese Elemente übersprungen, bevor der Filter aufgerufen wird, und ihr Text würde weiterhin besucht. Da NodeIterator die Baumstruktur nicht berücksichtigt, lassen sich damit keine ganzen Teilbäume ausschließen.
Zusammenfassung
Die folgenden Funktionen sind für die Auswahl von Elementen im DOM-Baum und die Traversierung von Knoten nützlich:
- Elemente anhand von ID, Klasse oder Tag-Namen auswählen:
getElementById()(auch fürDocumentFragmentverfügbar),getElementsByClassName()undgetElementsByTagName()(beide auch fürElementverfügbar). - Elemente mit CSS-Selektoren auswählen:
querySelector()für den ersten Treffer oderquerySelectorAll()für alle Treffer. Beide sind auch fürDocumentFragmentundElementverfügbar. - Ein Element prüfen oder seine Vorfahren durchsuchen:
matches()undclosest(). - Die Schnittstellen
NodeListundHTMLCollectionsind Array-ähnliche Sammlungen von Knoten beziehungsweise Elementen. Sie bietenlength, Zugriff über Indizes, Iteration unditem().NodeListbietet außerdemforEach(),entries(),keys()undvalues().HTMLCollectionbietetnamedItem()und den Zugriff über benannte Eigenschaften. document.createNodeIterator()erstellt einenNodeIterator, der Knoten mit seinen MethodennextNode()/previousNode()nacheinander durchläuft. Seine Position wird durchreferenceNodeundpointerBeforeReferenceNodedargestellt.document.createTreeWalker()erstellt einenTreeWalker, der Knoten in der gefilterten Baumansicht mit seinen MethodenparentNode(),firstChild()/lastChild(),previousSibling()/nextSibling()undpreviousNode()/nextNode()durchläuft. Seine Position wird durchcurrentNodedargestellt.- Die Bitmasken
NodeFilter.SHOW_*wählen Knotentypen aus; eine Filterfunktion oder die MethodeacceptNode()gibtFILTER_ACCEPT,FILTER_SKIPoderFILTER_REJECTzurück. NurTreeWalkerverwendetFILTER_REJECT, um Teilbäume auszuschließen.